Canva пусна първия си модел за генериране на изображения — Canva Craft. Обявен на 22 октомври, той е достъпен за всички потребители на платформата в раздела Dream Lab.
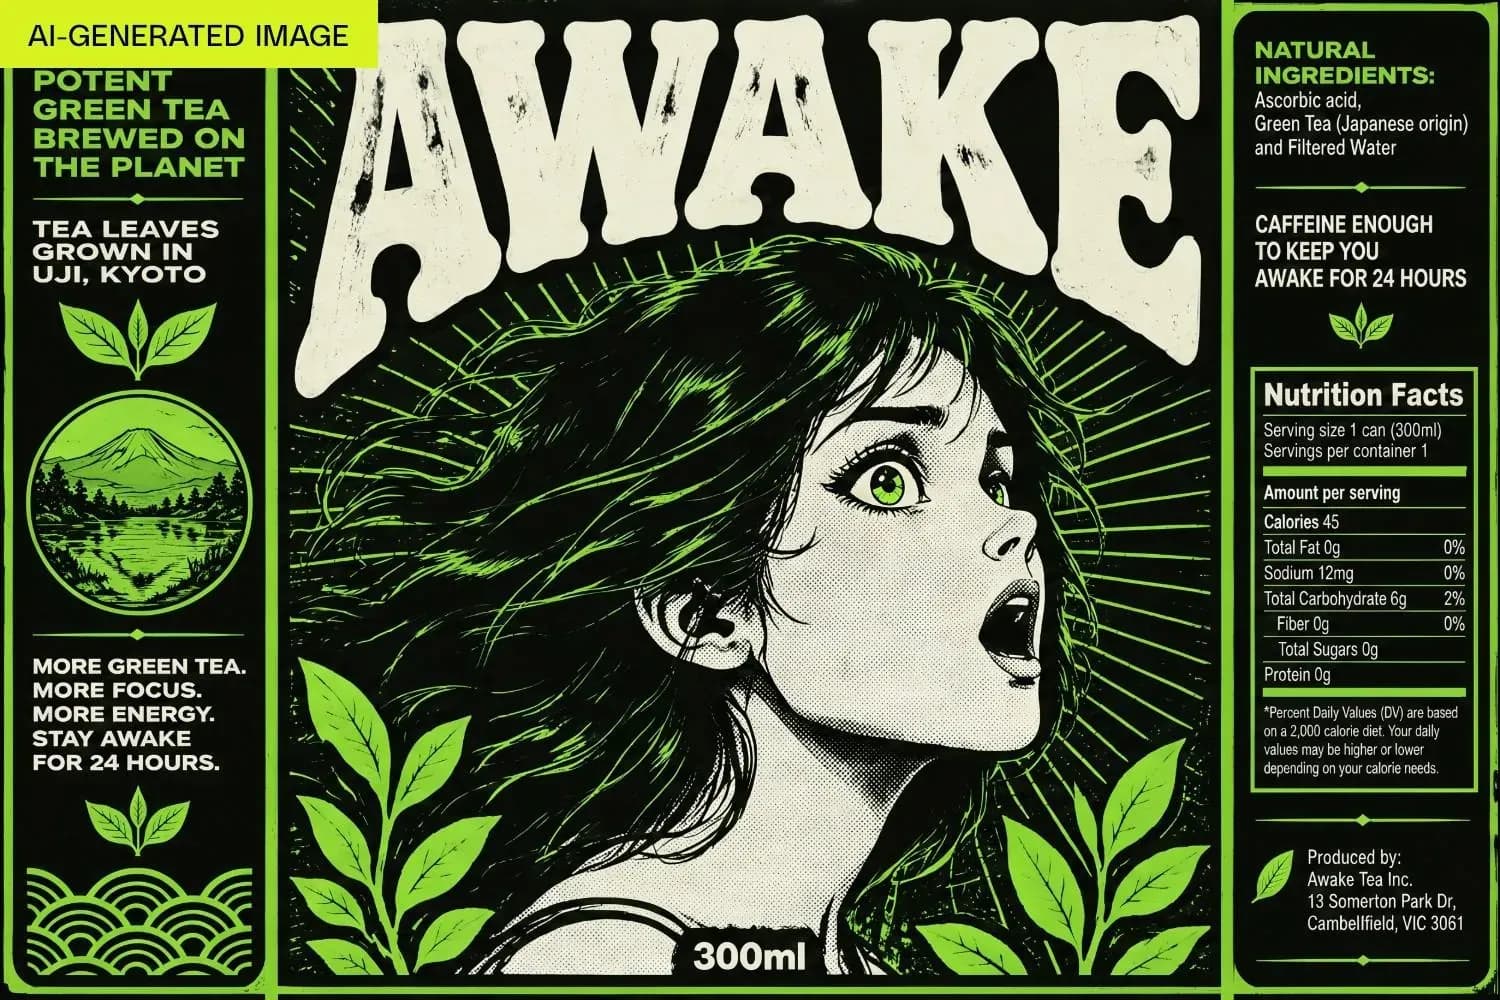
Според Canva създаването на изображение протича на два етапа. Първо моделът интерпретира текстовата заявка и планира разположението на елементите, относителните им размери, визуалната йерархия и текста. След това генерира изображение с резолюция до 2K. Според TechCrunch моделът поддържа 30 съотношения на страните за различни платформи, а The Verge посочва над 30.
Компанията твърди, че този подход позволява по-точно изобразяване на детайлите и четлив текст. По нейни данни потребителите могат да правят и прецизни промени в отделни части на изображението, без да се променят останалите.
За обучението Canva е използвала създадени от хора шаблони от собствената си библиотека вместо фотографии. Сред тях са плакати, публикации за социални мрежи, презентации, инфографики, менюта и оформления с акцент върху типографията. Генерираните изображения могат да бъдат превръщани в дизайни със слоеве чрез инструмента Canva Magic.
Моделът е разработен от изследователския екип на Canva с принос от изследователи на Leonardo.ai — платформата за генериране на медийно съдържание, която компанията придоби през 2024 г. Според Canva собственият модел ѝ дава по-добър контрол върху качеството, скоростта и разходите.
Предстои моделът да бъде достъпен и през Canva API. Компанията планира също да осигури генериране на изображения в ChatGPT и Gemini чрез своя MCP. Разработват се и две версии с по-ниски разходи — Craftfast и Craft-ultrafast, които според Canva ще бъдат пуснати скоро.
Все още няма коментари. Бъдете първият, който ще сподели мнение.